
こんにちは。AX研究室の Robert Hubacz です。2026年の夏、業務の一環として、The Pokémon CompanyがKaggleプラットフォーム上で開催したPTCG AI Battle ChallengeコンテストのSimulationカテゴリに参加しました。
コンテストの課題は、ゲーム用エージェント、すなわち他の参加者のエージェントを相手にPokémon Trading Card Gameの対戦を自動で行うプログラムを改良することでした。以下、これをコンテスト用エージェントと呼びます。以前に同様の問題に取り組んだことがなく、しかもこのゲームのルールも知らなかったため、私にとってはまったく新しい経験でした。そこでまずゲームの仕組みを理解し、その上でエージェントがどのように意思決定を行うべきかを考える必要がありました。
コンテストについて、もう一点説明しておきます。対戦中、エージェントは自律的に動作し、インターネットにはアクセスできません。現在の対戦状況に関する情報と許可された手のリストを受け取り、数秒以内に意思決定を行います。相手のすべてのカードを知ることはできず、いかなるヒントもありません。
新しいアイデアはそれぞれ、エージェントの新しいバージョンとして実装しました。加えた変更によってエージェントの成績が向上したかどうかを確認するため、新しいバージョンと前のバージョンの間で数百回の対戦を実行しました。新しいバージョンの勝利数が多ければ、それを優れたものと判断し、以後コンテストで使用しました。
こうすることで、変更の効果を判断する際には、エージェントが「なんとなくうまく戦っている気がする」という私の印象ではなく、テストの結果を基準にするようになりました。エージェントの新バージョンとテストの準備では、AIアシスタントに助けてもらいました。AIアシスタントの役割については、これらのテストの進め方に大きな影響を与えたため、最後に改めて触れます。
1か月の間にこうしたテストを60回以上実施し、その中でエージェント改良のための自分のアイデアを十数個検証しました。うまくいったのは一つでした。
この1か月を、うまくいったアイデアの数だけで評価すれば、見栄えの良い結果ではないでしょう。しかしすぐに分かったのは、次々と改良案を考え出すことそのものよりも、それらを信頼できる方法で、できるだけ低コストで検証する能力のほうがはるかに重要だということでした。それをうまく行う方法を身につけることが、このプロジェクトの主要な課題の一つになりました。
アイデアは素晴らしく見えました。最初のテストまでは
始まりは自信に満ちていました。敗戦を眺め、そこにパターンを見つけ、どのパターンも修正案を示唆していました。リプレイを見て、エージェントの何が悪いのか分かったと確信していました――あとはそれを直すだけだと。
しかし、テストは異なる結論を示しました。何度も、何度も。
最も記憶に残っているのは、最も長い間もっともらしく思えた分析です。分析対象として特定の種類の敗戦を選んだところ、エージェントが利用できる多くの選択肢を使わないまま対戦を終えていることに気づきました。使われずに残った選択肢は、他の敗戦よりも明らかに多かったのです。その差異は「エージェントの何が悪いのか」についての説得力のある物語を形作り、翌晩に向けた修正の計画もできあがっていました。
それを書く前に、これらの対戦をより適切に選んだ対戦セットと比較してみました。すると結論は正反対になりました。そのとき初めて、分析対象の対戦の選び方そのものがこの差を生んでいたのだと理解しました。エージェントの欠陥を発見したのではなく、自分自身によるデータ分割の結果を見ていたのです。作りかけていた修正は、存在しない現象に対処するものでした。
こうした経験を重ねた2週間を経て、二つのルールを導入しました。第一に、テストを始める前の時点で、どの結果をアイデアの裏付けと見なし、どの結果を棄却の根拠と見なすかを書き留めておくこと。基準を事前に決めていないと、得られた結果を自分のアイデアに有利に解釈しやすくなるからです。第二に、エージェントのバージョンの比較を始める前に、テストそのものの再現性を確認すること。同じエージェントを同じ方法で数回テストすると、結果が10パーセントポイントも異なることがありました。これは、以前に観察した「効果」の一部が、テストの誤差の範囲内に収まっていた可能性があることを意味しました。
最大の進歩をもたらしたのは、自作コードを手放したことでした
エージェント開発の前半、コンテストにおける私のリーダーボード順位は下がり始めました。当初の自作ソリューションを開発し続けていましたが、加えていた改良は、競争についていくには不十分でした。参加チームの数は毎日数十ずつ増え、その解法はどんどん良くなっていました。
コンテスト全体で最も効果的だった一手は、私の十数個のアイデアのどれでもなく、出発点を変えるという決断でした。自分のエージェントは他の参加者が公開している多くのソリューションより弱いと判断し、それらを、ライセンス条件に従って*、今後の作業の土台の候補としてテストし始めました。最終的に、自分の改良によってさらに発展させられる二つを選びました。まず一つ目の公開ソリューションに切り替え、これによって全体のほぼ中位から参加者の上位20パーセント前後まで順位を上げることができました。その後、さらに強力な二つ目の公開ソリューションへ移行しました。
自分のエージェントだけを開発するよりも、他の参加者のソリューションを活用したほうが良い結果を出せたと認めるのは、心が痛むことでした。しかし、まったく同じ罠が商用プロジェクトにも待ち構えています。「自分たちのもの」だからという理由で誰も代替案と比較しなかったソリューションを、何週間もかけてチューニングしてしまうことです。この経験は、何かを改良し始める前に、より良い出発点がすでに存在していないかを確認する価値があることを、私に思い出させてくれました。
しかし、公開ソリューションの活用は、タイトルにある「うまくいった一つ」ではありません。それは、選んだ二つ目のエージェントをさらに開発する中で生まれました。敗戦の分析から、エージェントが後の展開のために準備しているカードを十分に活用できていないことが示唆されました。そこで、そのような状況でカードへのリソースの割り当て順序を変える条件を一つ追加しました。掲載しているグラフは、開発期間中のリーダーボード順位の変化を示したものです。グラフに見える二つ目の大きな順位上昇は、この改良を含むバージョンのエージェントを提出した後に起きました。メカニクスの詳細には立ち入りません。規約がそれを認めていないからです。重要なのは、修正が小さかったこと、そしてそれを書く前に、説明した状況が実際にどのくらいの頻度で起きるのかを測定したことです――観戦した対戦から受けた印象だけで済ませるのではなく。
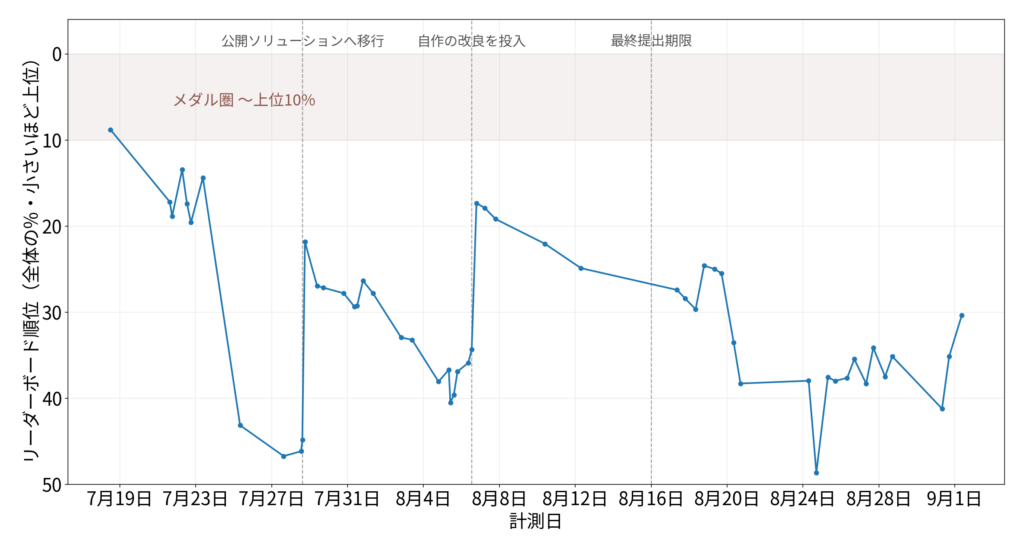
エージェント開発をリーダーボード順位の観点から見た図です。上部の網掛けの帯はメダル圏、すなわち全体の上位10%を示します。1回目のほぼ垂直な順位上昇は、より強力な、公開されているソリューションに乗り換えた時点です。2回目は、別の公開ソリューションに私の改良を加えたバージョンのエージェントを提出した後に起きました。8月16日以降はエージェントを更新できなくなり、エージェント間の対戦数が増えていきます。この期間にはリーダーボード順位のかなり大きな変動が見られ、最終的に6,807チーム中2,064位、すなわち全体の上位30.3%で終えました。
AIは答えをくれませんでした。間違うことのコストを下げてくれました
コンテスト用エージェントの開発では、AIアシスタント(Claude)の助けを借りました。コードの断片の作成、バグの発見、テストの準備、ドキュメントの作成などを手伝ってもらいました。しかし、どのアイデアを検証するか、テストをどう設計するか、どの結果に基づいて効果を評価するかを決めたのは私です。
AIアシスタントは、エージェントの開発とテストの間だけ使用しました。コンテスト参加者に提供されたデータを受け取ることも、対戦に参加することもありませんでした。競技中、コンテスト用エージェントはインターネットへのアクセスも言語モデルとの接続もなしに、自律的に動作しました。
そしてここで、最も重要な観察にたどり着きます。AIアシスタントを使っても、私の考えが当たる頻度が高くなったわけではありません。敗戦を分析するとき、私はエージェントがなぜ悪い動きをしたのかについての仮説を立てていました。アシスタントは、その仮説を検証するための適切なコード変更とテストを素早く準備するのを手伝ってくれました。
多くのアイデアは説得力がありましたが、テストの結果はそれを否定しました――時にはその日の夜のうちに。つまりAIの価値は、的確な答えを与えることではなく、アイデアの検証に必要な時間を短縮することにありました。以前ならテストコードを書くのに半日かかっていたであろう作業が、十数分で済みました。おかげで一晩のうちにいくつかのバリエーションを検証でき、その一つひとつに何日も費やさずに済みました。
最終的に、検証した十数個のアイデアのうち、うまくいったのは一つでした。残りを素早く棄却できたことにも価値がありました。各アイデアの検証は数週間ではなく数時間で終わり、単なる感触ではなく具体的な結果を残しました。エンジニアリングの仕事で最も高くつくのは、間違ったアイデアではなく、誰も十分早い段階で検証しなかったアイデアなのです。
エージェントの提出受付は2026年8月16日に終了し、最終ランキングは月末の追加評価の後に確定しました。この追加評価の期間中もエージェント間の対戦は続いたため、順位はその間も変動しました。最終的に、私は6,807チーム中2,064位、すなわち全体の上位30.3%に入りました。60回以上のテスト結果を記録したログは、順位表のどんな順位よりも長く私の手元に残るでしょう。
* 使用したソリューションは、このような利用を認めるApache 2.0ライセンスで公開されています。作者の表示とライセンスに関する情報は、私のプログラムのファイルに記載されています。
Pokémonおよび関連する標章は、それぞれの権利者の商標です。コンテストには、業務の一環として個人のKaggleアカウントで参加しました。本記事は、エコモット株式会社とコンテスト主催者との協業や提携を意味するものではなく、コードおよび保護対象のコンテスト資料を含みません。
本記事はAIアシスタント(Claude)との協働で執筆しました。Claudeはエージェントのコードやグラフ生成スクリプトの作成も支援しました。グラフのデータは、私自身が行ったコンテストのリーダーボード順位の読み取りに基づいています。冒頭のイラストはAI(Gemini)によって生成されました。