
雨天時の売上インパクトをモデル推定する時の罠はSELECT文だった
オープンデータ(UCI Bike Sharing, 17,379時間)の検証
こんにちは!AX研究室の庄内です。
突然ですが・・・
”モデル精度にこだわっていませんか?”
今日は、そんなあなたに”因果推論”の話をしたいと思います。
「雨の日って、結局うちのシェアサイクルどれくらい売上落ちてる? 来期の『雨の日クーポン』の予算を取りたいから、パッと数字出して」
夕方のSlackに、事業責任者からこんな一行が飛んできたとします。
手元には全ログがある。SQLも書ける。BIツールの操作もお手のもの。5分で返せそうな質問です。ところがこの質問、集計のやり方ひとつで答えが2倍以上ぶれちゃうんです。
しかも厄介なことに、「いちばん真面目に多変量解析をやった方が、いちばん大きく外す」と言われたら、どう思いますか?
この投稿は、公開データを使って実際に「雨の効果」を見積もった記録です。途中で立てた仮説が見事に外れるので、その失敗の過程も含めてお楽しみください。
この投稿に出てくる用語解説
| 用語 | 一行で言うと |
|---|---|
| 過剰調整バイアス(over-adjustment) | 正しく調整したつもりで、効果を握りつぶす事故 |
| 中間変数(mediator / post-treatment variable) | 原因の「結果として」動く変数。入れてはいけない |
| ヌーサンス関数(局外母数) | 知りたくもないのに、答えを支配している関数 |
| 直交化 / Neyman直交性 | 推定値が「間違ったモデル」に鈍感になる性質 |
| 共通サポート(重なり) | そもそも比較できる相手がいるのか、という問題 |
データ|使うのはこれだけ
| データセット | UCI Bike Sharing Dataset(hour.csv) |
| 中身 | Washington D.C. の Capital Bikeshare、1時間ごとのレンタル台数と気象 |
| 期間 | 2011-01-01 〜 2012-12-31(17,379時間) |
| 平均需要 | 189.5台/時間 |
| 「雨」の定義 | weathersit >= 3(小雨・雷雨・小雪以上)= 1,422時間(全体の8.2%) |
| 配布元 | archive.ics.uci.edu/dataset/275 |
まず、誰でもやる集計から
最初のクエリは GROUP BY is_rain。平均を引き算するだけです。
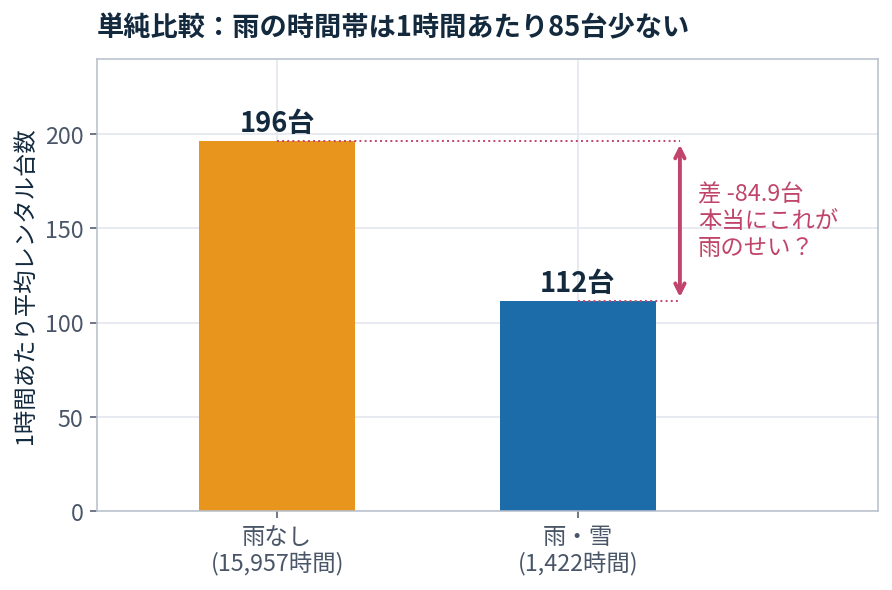
−84.9台。「雨が降ると1時間に約85台減ります」と返しかけて、データの勘が働く方は立ち止まります。
雨が降るのは気温が低い日が多いし、夜間にも降る。この−85台には、寒さや時間帯による落ち込みも混ざっているはずだ、と。
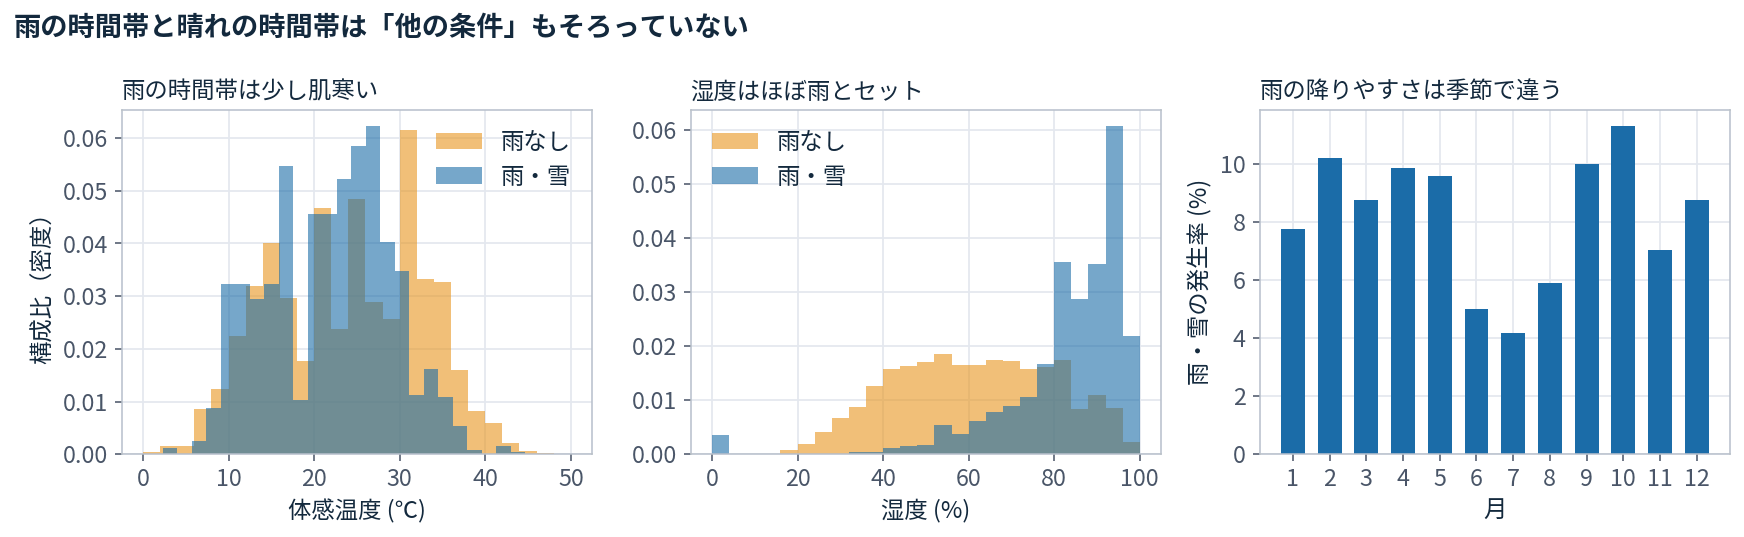
そこで背伸びをして重回帰分析を走らせます。気温、体感温度、湿度、風速、時間帯、曜日、季節、月、年。DBから引っこ抜ける気象・日時の特徴量を全部、説明変数に入れます(いわゆる SELECT * の精神です)。
−30.4台。
3分の1近くまで縮みました。「落ち込みの大半は雨のせいではなく、寒さや時間帯のせいだった。雨そのものの影響は30台程度にすぎない」・・・極めて筋の通った話です。これをもとに「雨天クーポンの予算は少額でいいですね」と稟議が通りかけました(もちろん、そう簡単にはいきません)。
この投稿がたどり着く答えは、−70.1台 です。
丁寧に全部コントロールしたはずの重回帰が、何も考えなかった単純平均より大きく外していたのです。しかも効果を小さく見せる方向に。これでは予算が完全にショートします。雨のインパクトを半分以下に見積もったまま、対策予算を削る判断が通ってしまうところでした。
最初に立てた仮説:犯人は非線形性に違いない!
最初に思いつくのは、大体こうです。「犯人は線形回帰の限界(非線形性)だ」と。
現実の人間の行動が、きれいな直線になるハズがありません。中身がすべて可視化できるガラスボックスモデル EBM(Explainable Boosting Machine) で、体感温度と需要の関係を描かせると、その確信は深まります。
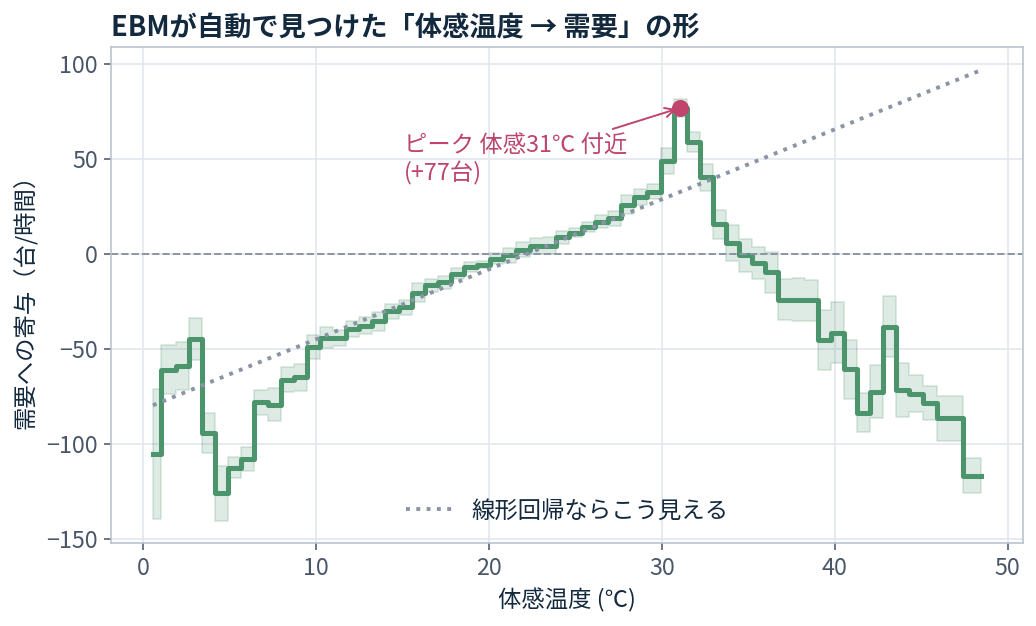
体感31℃を超えたところで需要はピークアウトし、そこから急降下します。猛暑に汗だくで自転車を漕ぐ人はいません。ところが点線を見てください。直線しか引けない線形回帰は、このピークアウトを認識できず「暑いほど需要が伸びる」と主張しています。
高温域で説明がつかなくなった誤差は、どこかに行き場を求めます。夏場の夕立と時期が重なることで、その誤差が「雨の係数」に押し付けられた——そう考えれば辻褄が合います。
時間帯も同じです。
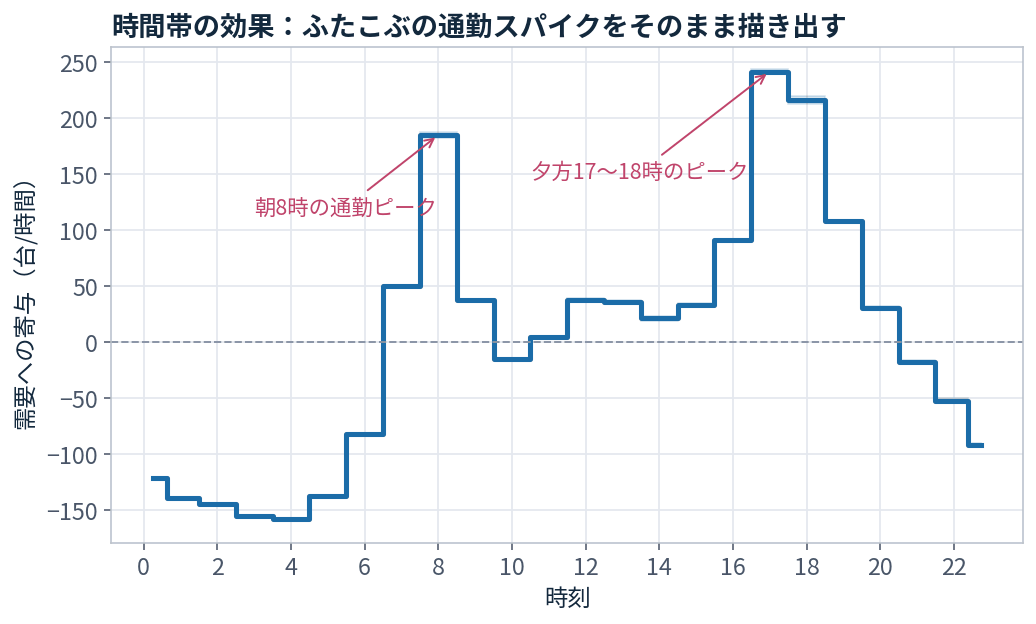
「非線形性を捉えられない古い統計モデルを使ったのが敗因だ」。そう結論づける前に、念のためモデルの表現力の差を確かめておくことにしました。
6通り回したら、仮説が外れた
学習器を3通り(線形回帰・GBDT・EBM)、投入する変数を2通り(湿度と風速を入れる/外す)。掛けて6通り。すべて同じ因果推論の枠組み(DoubleML)に載せて、条件をそろえます。
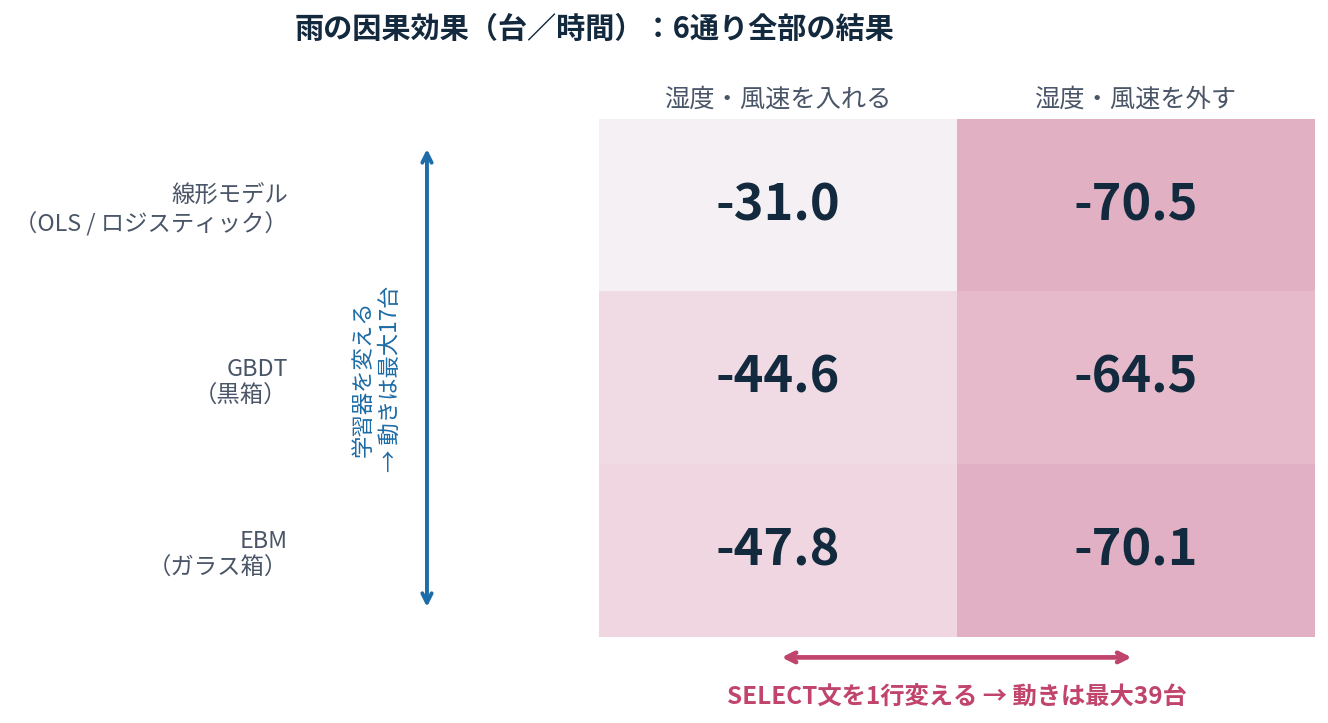
| 学習器 | 湿度・風速を入れた場合 | 湿度・風速を外した場合 |
|---|---|---|
| 線形回帰(OLS+ロジスティック) | −31.0台 | −70.5台 |
| GBDT(勾配ブースティング木) | −44.6台 | −64.5台 |
| EBM(ガラスボックスモデル) | −47.8台 | −70.1台 |
縦(モデルの賢さ)を見る
湿度・風速を外した右列を見てください。原始的な線形回帰が −70.5台、GBDTが −64.5台、EBMが −70.1台。ほぼ同じ「約−70台」に着地しています。モデルをいくら高度にしても、数字はせいぜい数台から十数台しか動きません。
横(変数の選び方)を見る
左列と右列を見比べてください。どの学習器でも、湿度と風速を入れるか外すかだけで、最大39台——倍以上の差が出ています。
最初の仮説は見事に外れました。非線形性は無罪ではありません。湿度を入れた左列の中では、線形の−31.0台からEBMの−47.8台まで17台の差がついています。しかし主犯ではありませんでした。湿度を外したとたん、学習器の違いによる差はほとんど消え去ったのです。
真犯人は、アルゴリズムではなく、何気なく書いたSELECT文の「たった2つのカラム」でした。
この順序で確かめていなければ、「非線形性が原因だ」という、もっともらしいけれど的外れな解説記事を公開するところでした。仮説が正しいかどうかは、他の条件を固定して両方試すまで分かりません。比較表を作るのは格好つけではなく、最低限の検証手続きなのです。
では、良かれと思って入れた湿度は何をしていたのか?
「雨の分析なんだから、気象データにある湿度を入れるのは当たり前だろう」。誰もがそう思います。しかし、ここで起きているのが 過剰調整バイアス(over-adjustment)です。
因果の矢印を書くと、理由が一目瞭然になります。
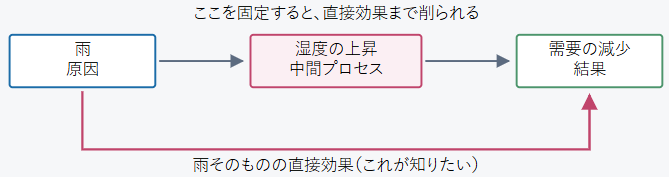
雨が降ると湿度が上がります(このデータでも、雨天時の平均湿度は83%、それ以外は61%です)。重回帰に湿度を入れて固定するということは、「同じ湿度の時間どうしで、雨が降った時間と降らなかった時間を比べる」という無茶な比較をしていることを意味します。
すると、「雨でジメジメしたから乗りたくない」という需要減のダメージがまるごと湿度の手柄になり、雨自身のインパクトがその分だけ不当に削ぎ落とされてしまいます。
- 入れていい変数(交絡因子): 雨と需要の両方の原因になっているもの(季節、時間帯、気温など)
- 入れてはいけない変数(中間変数): 雨が降った結果として動くもの(湿度、風速、路面状態、雨天時だけ発動する施策など)
この判断に統計的な検定はありません。むしろ予測精度だけで特徴量を選ぶと、確実に間違った方を選ぶことになります。湿度は「雨が降っているかどうか」を予測する精度を劇的に上げてしまうからです。
「比較相手がいない」という、もうひとつの問題
EBMで「雨が降る確率」を可視化すると、別角度からの決定的な証拠が出てきます。
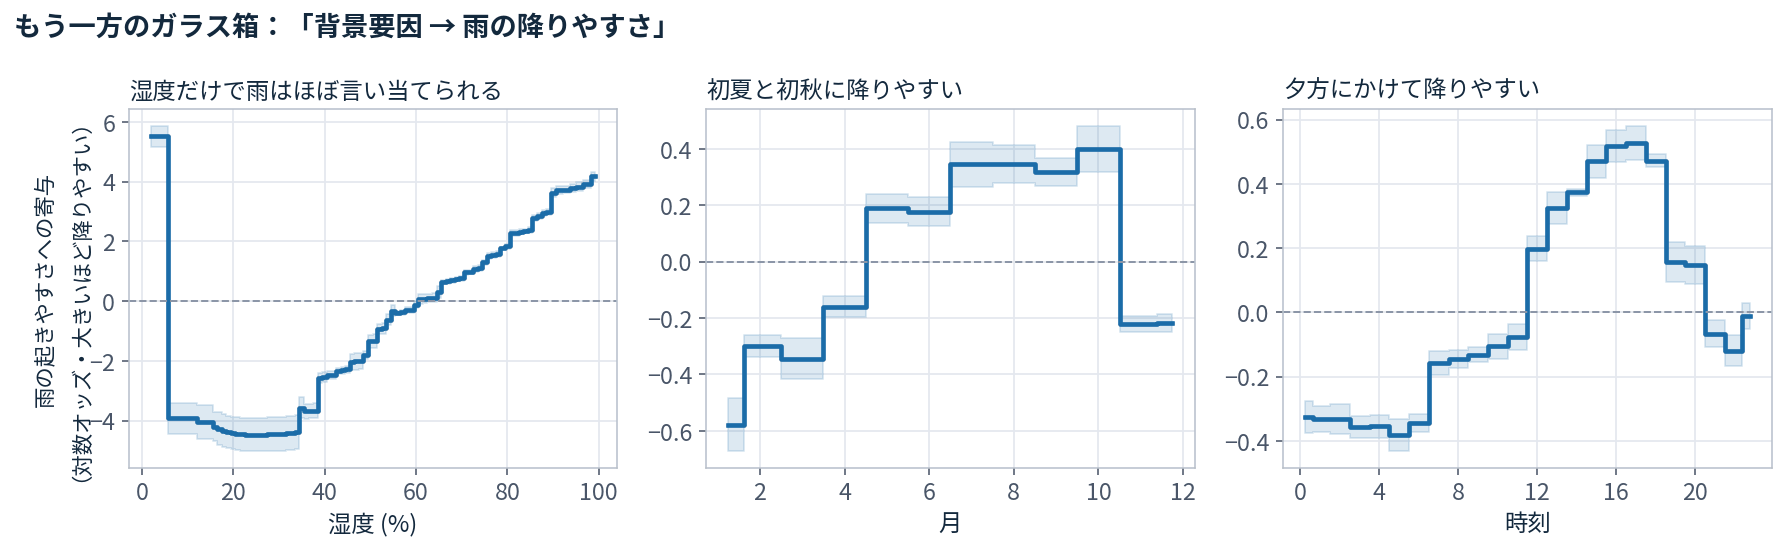
湿度が80%を超えると、降雨オッズが垂直に立ち上がります。これは当然で、雨が降っている最中は湿度が高いからです。つまり湿度を特徴量に入れた瞬間、モデルの中では「湿度が高いのにカラッと晴れている時間帯」という、現実にはめったに存在しない比較相手を探すゲームが始まってしまいます。
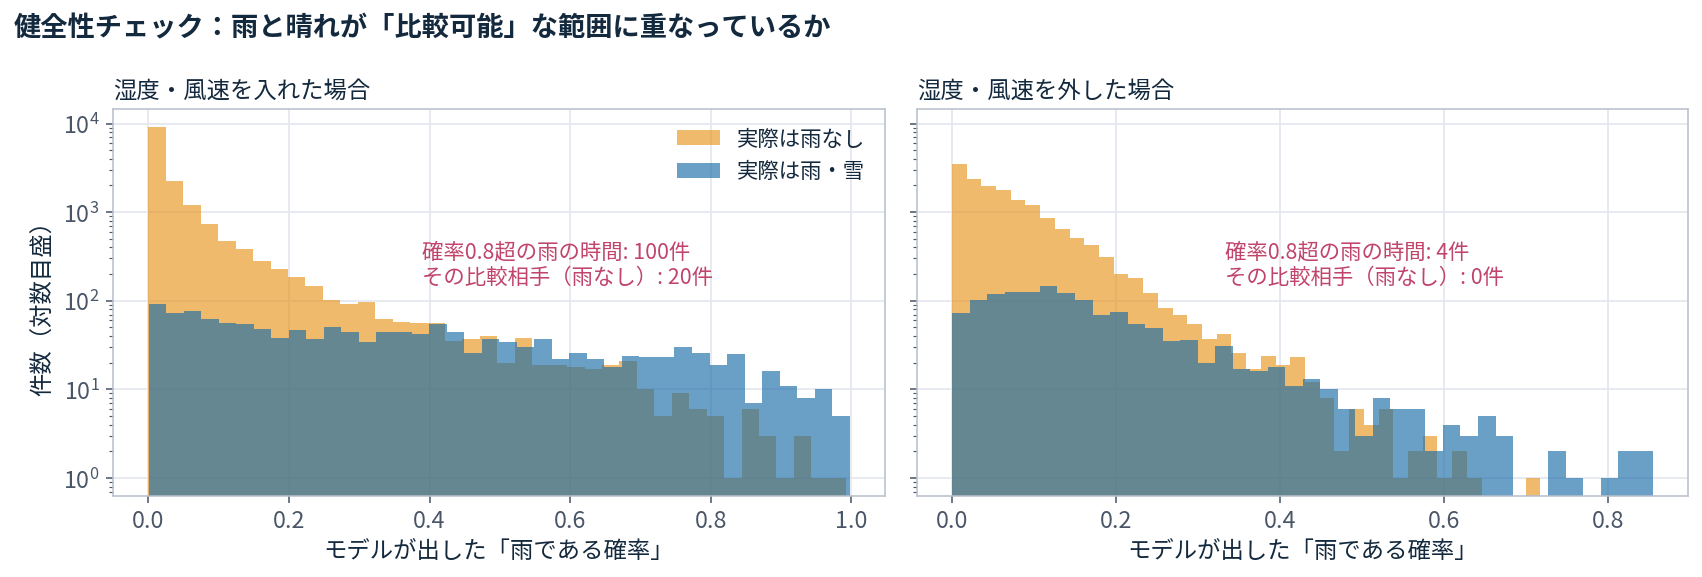
実際に数えると、湿度を入れたモデルでは「雨である確率0.8超」と判定された雨の時間が100件あるのに対し、比較相手になる雨なしの時間はわずか20件しかありません。これを 共通サポート(common support)の崩壊と呼びます。比較相手がほとんどいない領域で無理に効果を推定した結果、推計値が狂ってしまうのです。
では、EBM × DoubleML は何のためにあるのか
「湿度さえ抜けば普通の線形回帰でも−70.5台が出るなら、難しい機械学習は要らないのでは?」
もっともな疑問ですが、実は順番が逆です。湿度という犯人を特定できたのは、中身の見えるEBMを使ったからに他なりません。
もしこれがブラックボックスなモデル(LightGBMなど)単体だったら、−44.6台という中途半端な数字が出たとき、なぜその数字になったのか誰も説明できません。「AIが出した数字だから」と鵜呑みにするしかなくなります。
ガラスボックスモデルであるEBMを使ったからこそ、
- 湿度80%超が、ほぼ雨フラグと同義になっていること
- 平日朝8時の通勤ピークが、休日にはきれいに消えること
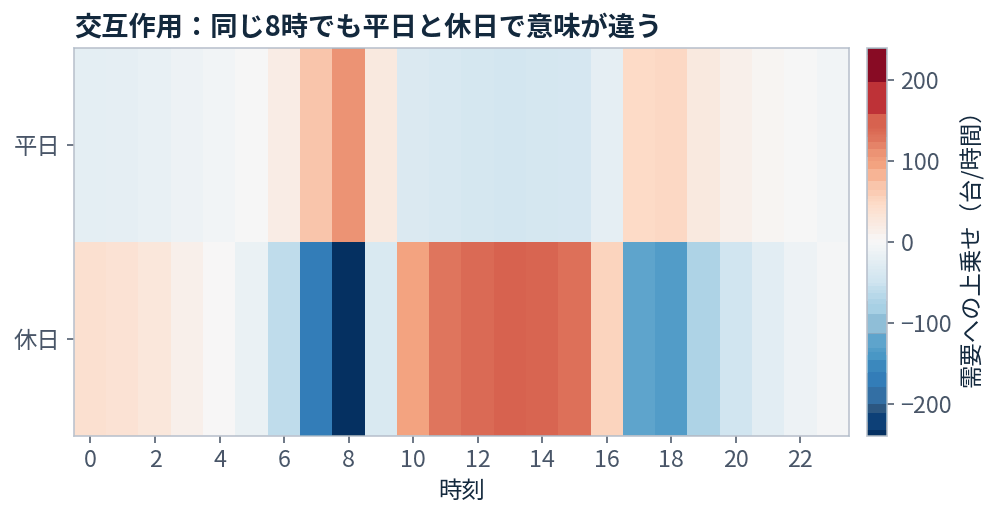
この二つをグラフとして目の当たりにし、「湿度は中間変数だから抜かなければいけない」と人間が気づくことができました。EBMの真の役割は単に答えを出すことではなく、自分がどこで間違えているかを教えてくれることなのです。
DoubleMLが担当している役割
そこにDoubleML(Double Machine Learning)を組み合わせます。行っている処理は極めて明快な3ステップです。
- 機械学習で背景要因から「需要」を予測 ➔ 予測しきれなかった【需要のズレ】を抽出
- 機械学習で背景要因から「雨の確率」を予測 ➔ 予測しきれなかった【雨のズレ】を抽出
- ズレ同士をぶつける(直交化) ➔ 背景要因が相殺され、純粋な雨の効果だけが残る
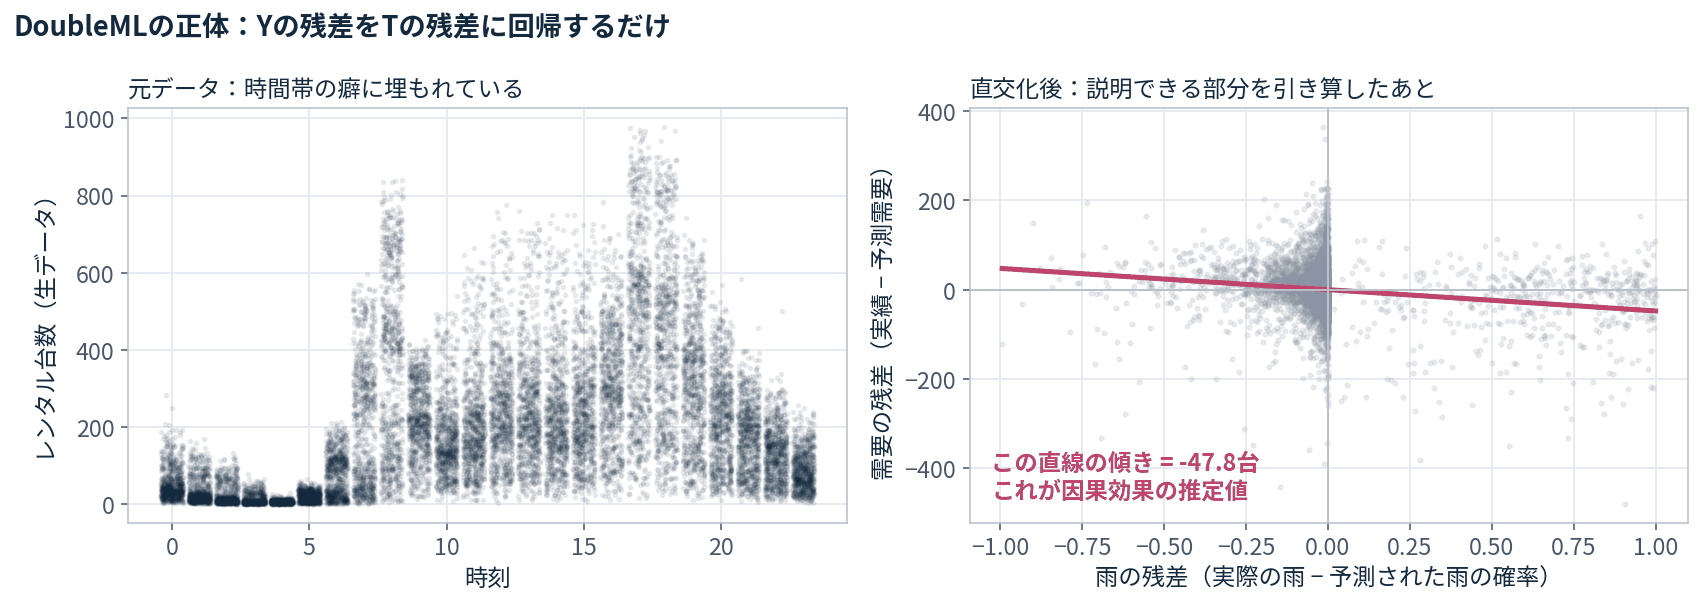
なぜわざわざこの形にするのでしょうか。機械学習モデルは予測誤差を小さくするために係数を縮めたり枝を刈ったりします(正則化)。それは予測には有利ですが、因果効果の推定値に小さな偏りを持ち込んでしまい、そのままでは信頼区間が正しく引けなくなります。
直交化された推定式は、この偏りに対する1次の感度がゼロになるよう数学的に設計されています。言い換えると、ヌーサンス関数(=私たちが直接興味を持っていない、背景要因まわりの関数)が多少間違っていても、求めたい因果効果の推定値がほとんど揺らぎません。これを Neyman直交性 と呼びます。機械学習の強烈な表現力をフル活用しながら、統計学的な信頼区間つきの因果効果を取り出せるのは、この仕組みのおかげです。
相関を並べるダッシュボードから、意思決定のための分析へ
集計の仕方ひとつで、会議室の結論はここまで変わります。
【最終推定結果】
雨による需要インパクト: −70.1 台/時間
(95%信頼区間: −75.1 〜 −65.1 / 平常時需要 189.5台に対して −37%)
- 単純な平均差 −84.9台 は、寒さや夜間の影響まで巻き込んだ過大評価。
- 全部入れた重回帰 −30.4台 は、湿度に効果を奪われた過小評価。
BIツールで売上と何かの「相関」を可視化して満足するだけでは、ビジネスの判断を誤らせてしまいます。事業が本当に知りたいのは、「この事象が起きたら、あるいはこの施策を打ったら、売上が純増・純減するインパクトはいくらか」という因果の答えだからです。
そのために必要なのは、必ずしも魔法のような超高難度アルゴリズムではありません。手元にあるカラムを無邪気に全部 SELECT するのをやめ、データの背後にある「因果の矢印」を丁寧に想像すること。
Pythonの doubleml と interpret を使えば、ここまでの推定はほんの数行のコードで再現できます。SQLとダッシュボードを一通り作れるようになった分析者にとって、因果推論は「自分の分析で事業の意思決定を正しく導く」ための、最高に刺激的な次の一歩になるハズです。
データドリブン/AI-nativeについての相談はAX研究室までご連絡ください。
この投稿の補足と分析の限界
- 未観測の交絡は消せません。 大規模イベント、道路工事、競合サービスのプロモーションなど、データに含まれていない要因による交絡はDoubleMLでも除去できません。これらに対処するには自然実験や操作変数法、差分の差分法(DID)といった研究デザインの設計が必要です。
- 雨の強さを区別していません。 今回は
weathersit >= 3として小雨・本降り・雪を同一の介入として扱っています。 - 全体平均効果(ATE)です。 「どの時間帯や季節に特に雨の影響が大きいか」を知るには、異質効果(CATE)の推定に進む必要があります。
- 2011〜2012年のワシントンD.C.のデータに基づきます。
データについて
データ出典:UCI Machine Learning Repository, Bike Sharing Dataset(Fanaee-T & Gama, 2013)。CC BY 4.0。